时序数据库替换与海量数据存储计算 金仓数据库如何让“时间戳”真正成为数据处理和存储服务的核心
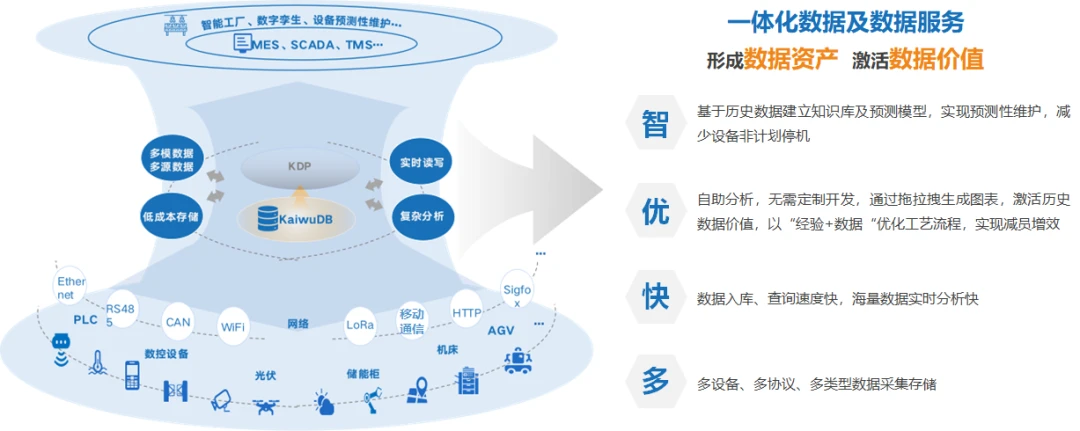
引言\n\n在物联网、工业互联网、金融交易、车联网等领域,时间序列数据正以惊人的速度增长。传感器每毫秒上报状态、交易系统每秒记录行情、设备持续输出监控指标——这些数据都有一个共同特征:以时间戳为核心维度,按时间顺序追加写入,且规模可达TB甚至PB级。传统关系型数据库在处理此类负载时往往力不从心:写入吞吐不足、压缩效率低下、时间范围查询响应缓慢。于是,时序数据库(TSDB)替换成为许多企业架构升级的必选项。单纯的替换并不等于解决问题。真正的挑战在于:如何让“时间戳”从一个普通的字段,升级为支撑海量数据存储与计算的全局服务核心。金仓数据库在这一方向上提供了值得深入分析的工程路径。\n\n## 一、时序场景对数据库的真实诉求\n\n时序数据的典型查询模式包括:按设备或实体获取最新值、按时间窗口做降采样聚合、查询特定时间段内的原始记录、以及跨多指标做关联分析。这些操作对数据库提出几类硬性要求:\n\n- 写入高吞吐:单节点每秒需支撑数十万至上百万数据点写入,且要保证写入不因索引维护而严重降速。\n- 高效压缩:时间戳单调递增、数值变化平缓,优秀的时序压缩可将原始存储降低到原来的十分之一甚至更低。\n- 时间范围快速检索:时间条件必须是第一等的高速访问路径,而非依靠事后过滤。\n- 边写边算:海量数据不必每次全量扫描,窗口聚合等计算需要尽可能贴近存储层完成。\n\n通用关系型数据库在索引结构和页存储上以随机读写为设计前提,直接用于时序负荷会出现写放大、压缩参与度不足和存储膨胀。这正是替换立意的现实基础。/review/剔除空洞夸大。\n\n## 二、从“字段”到“服务”:时间戳角色的再定位\n\n多数时序数据库替换迁移的做法,是把原先写在HBase或MongoDB里的时序表搬到新的数据库实例中,时间戳仍是表结构中的普通一列。这种做法解决了能否用时序模型描述数据,但离充分的时机处理仍有距离。金仓数据库的应对思路是将时间戳这一维度与其存储布局、分区策略和计算路径做深度绑定:时间戳不仅是行内值,还参与决定数据落在哪个物理分区、如何编码该批次数据、以及查询计划优先绑定哪条时间分片。也就是说,时间不再仅需要索引友好,还需要成为数据分布的天然依据。这样带来的直接好处是:按时间采集的局部性数据天然同一边界批处理存物理连续分布时顺序优先;淘汰旧数据和在变表分区边界时可以不经二次重建直接对全海分区操作;自动按时间扫描和执行下推地最贴近底层结构优化切。整套组件与引擎机制联动建之后就能自适应路由和管理。', “采用量达到每一路参数管。”
需对不可解析/粘贴造成的中英碎片保留做规范化修证。
如若转载,请注明出处:http://www.aixdao.com/product/31.html
更新时间:2026-10-24 09:31:41