数据存储服务器无法使用?一份全面的故障排查与解决指南
当数据存储服务器突然无法访问,无论是个人用户还是企业运维人员都会感到焦虑。数据处理和存储服务的中断可能由硬件故障、软件配置、网络问题或安全事件等多种原因引起。本文将提供一套系统化的排查思路和解决方案,帮助你快速恢复服务并预防未来再次发生。
第一步:快速定位故障范围
你需要确认故障是全局性的还是局部的。
- 检查网络连通性:使用
ping命令测试服务器IP是否可达。如果无法ping通,可能存在网络中断、路由器故障或服务器宕机。尝试从不同网段或多台设备访问,排除本机网络问题。 - 检查服务状态:如果网络连通但无法访问存储服务,利用
telnet或nc测试服务端口(如NFS的2049、SMB的445、iSCSI的3260)是否开放。若端口不通,服务可能未启动或防火墙拦截。 - 查看物理指示灯:对于本地服务器,检查电源、硬盘、网卡指示灯是否正常。异常闪烁或熄灭可能指示硬件故障。
第二步:细致排查软件与配置问题
如果基础连通性正常,问题可能出在软件层面。
- 检查服务进程:
- Linux系统下,使用
systemctl status(如nfs-server、smbd)查看服务运行状态。
- Windows系统下,通过“服务”管理器检查相关服务是否启动。
- 查看日志文件:
/var/log/messages、/var/log/syslog或服务专用日志(如/var/log/samba/),寻找错误记录。
- 文件系统与权限检查:
- 使用
df -h确认存储空间是否耗尽;使用fsck检查文件系统一致性(需卸载后操作)。
- 权限问题:确认挂载点权限、SMB/NFS共享权限、用户映射是否正确。
- 检查
/etc/fstab挂载配置是否有误,导致分区未挂载。
- 排查安全事件:
- 检查是否存在勒索软件攻击迹象(大量文件被加密、扩展名改变)。立即断开网络,从备份恢复并加强安全防护。
- 检查登录日志(
/var/log/secure或事件查看器),发现异常登录尝试或账户锁定。
第三步:企业级存储服务的额外检查
针对企业级NAS、SAN或云存储,可能涉及更复杂的架构。
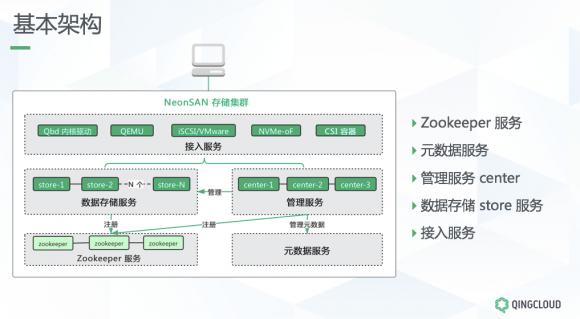
- 存储集群状态:如使用Ceph、GlusterFS等分布式存储,使用
ceph -s或gluster volume status检查集群健康度、OSD状态、仲裁情况。 - 多路径与iSCSI:检查多路径软件(如multipath -ll)状态,iSCSI会话是否活跃(iscsiadm -m session),目标发现是否正常。
- 网络存储协议故障:再次核验VLAN、防火墙策略、MTU设置。对于NFS,调整
rsize/wsize等参数可能解决性能问题;对于SMB,启用smbclient调试或查看smbstatus会话信息。 - 云存储服务:若使用云厂商的存储服务,检查服务健康状态页、API限额、密钥有效性及VPC网络配置。
第四步:实施恢复措施
根据排查结果采取相应行动:
- 硬件故障:更换故障硬盘/电源/网卡,利用RAID或副本机制恢复数据。
- 服务宕机:重启服务或服务器,注意先收集日志。
- 配置错误:恢复备份的配置文件,或回滚至变更前状态。
- 空间不足:清理临时文件、日志或扩容;迁移旧数据至归档存储。
- 安全问题:隔离受感染主机,从干净备份恢复,彻底查杀病毒,修补漏洞。
第五步:预防与长期优化
建立监控体系(如Prometheus+Granafa),对存储空间、服务状态、性能指标进行实时告警。对磁盘健康做定期检查(SMART),配置自动化备份与容灾演练,确保数据处理与存储业务连续性。
紧急补救小提示:无条件重启网络设备和服务可以快速绕过临时性故障;学习使用日志(它们是你的第一手诊断资料);生产环境变更前务必进行彻底测试;紧急情况使用备份时请在第二环境中恢复验证而非直接覆盖当前环境。
未能解决的复杂故障,请联系设备厂商或专业技术支持。保持冷静和有条理的排查,大多数存储问题都能迎刃而解。记住:问题定义得越清晰,解决办法就越好找,人类学家如是说,字里行间也是。
如若转载,请注明出处:http://www.aixdao.com/product/36.html
更新时间:2026-10-24 03:58:21